Un contenedor puede mostrar Up y, al mismo tiempo, exponer un servicio inaccesible. Puede reiniciarse porque el proceso termina, porque falla una dependencia o porque el host se queda sin memoria. Y un volumen puede contener los datos correctos aunque hayamos recreado la aplicación equivocada. Ninguno de esos síntomas se resuelve por defecto reconstruyendo la imagen o reiniciando todos los servicios.
La propuesta de este artículo es utilizar Docker como sistema observable: recolectar evidencia antes de cambiar el estado, formular una hipótesis verificable y delimitar qué capa está fallando. La CLI ofrece datos precisos; Lazydocker ayuda a navegar procesos, contenedores, logs y recursos. No compiten entre sí ni sustituyen métricas de aplicación o trazas distribuidas.
La referencia documental es Docker Engine 29.10.0 (release del 16 de noviembre de 2026) y Lazydocker v0.25.2; los comandos se aplican en una máquina Linux con Docker Engine y Compose V2, salvo que se indique lo contrario. Los escenarios y sus resultados esperados son propuestas de laboratorio, no incidentes experimentados ni pruebas ejecutadas. En Docker Desktop cambian detalles de red y del host debido a su máquina virtual.
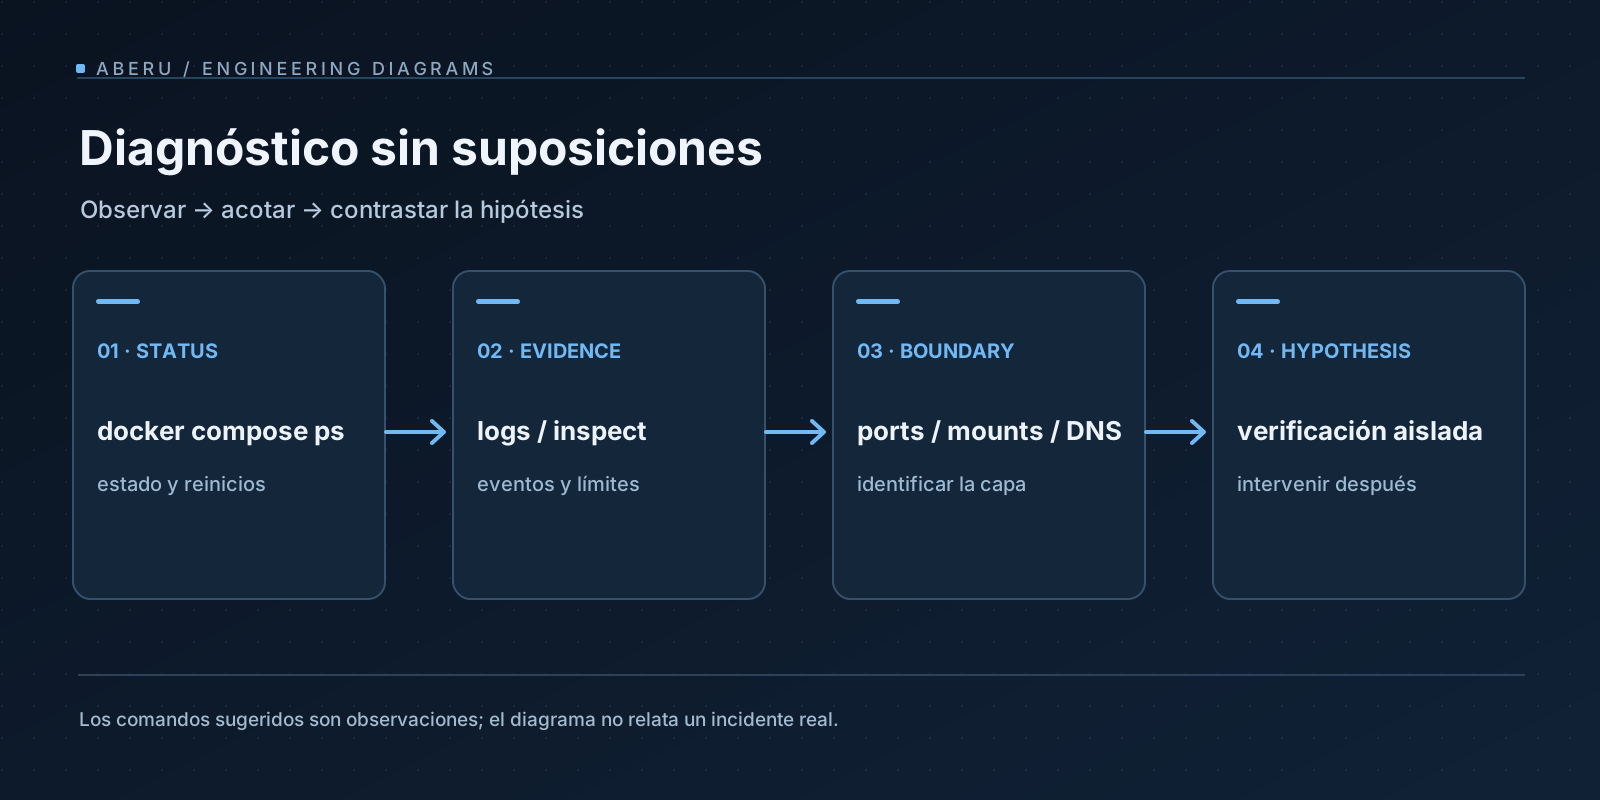
Del síntoma a la capa: no hay un único «Docker»
Antes de tocar un contenedor, conviene dibujar mentalmente las fronteras implicadas:
| Capa | Ejemplo de fallo | Evidencia que necesitamos |
|---|---|---|
| Proceso de aplicación | Se cierra con código distinto de cero; escucha en interfaz incorrecta | Logs, exit code, comando y configuración efectiva |
| Runtime / contenedor | Reinicios, health check fallido, OOM | Estado en inspect, eventos, límites de memoria |
| Red interna | Servicio A no resuelve o no alcanza B | Redes, DNS de Compose, nombre de servicio y puerto interno |
| Publicación / proxy | El servicio responde dentro pero no desde el host | ports, listeners, firewall, proxy, TLS y DNS público |
| Persistencia | Datos aparentemente desaparecidos tras recrear | Mounts, volumen real, rutas de escritura y ownership |
| Host | Disco, memoria, CPU o I/O saturados | Métricas del host, Docker events, estadísticas |
Docker usa namespaces para aislar vistas de recursos y cgroups para control/contabilidad, pero un contenedor no es una máquina virtual completa. Su proceso usa el kernel del host en Linux. Además, el sistema de archivos escribible del contenedor y los volúmenes tienen ciclos de vida distintos: la capa escribible pertenece al contenedor; el volumen es un objeto de persistencia externo. Véanse la arquitectura de Docker, la documentación de almacenamiento y la de volúmenes.
Esta separación cambia la pregunta de diagnóstico: no «¿por qué falla Docker?», sino «¿qué frontera se ha roto y qué evidencia la distingue de las alternativas?».
Primera pasada: cinco observaciones de solo lectura
Para un proyecto Compose llamado, por ejemplo, tienda, empezaría por identificar los servicios y su estado. Los nombres son ilustrativos; no se asume la existencia de ese proyecto.
# Ejecutar desde el directorio que contiene compose.yaml.
docker compose ps -a
# Una ventana de logs limitada evita ocultar el inicio del fallo.
docker compose logs --timestamps --tail=150 api
# Ver configuración interpolada: puede revelar secretos. No compartir la salida.
docker compose config --services
# Inspección del contenedor por nombre/ID obtenido de `ps`.
docker inspect --format '{{json .State}}' CONTAINER_ID
# Eventos recientes, con intervalo finito y timestamps.
docker events --since 10m --until 0s --filter type=container
La salida de docker inspect incluye Running, Restarting, ExitCode, OOMKilled, Error, tiempos de inicio/fin y, si existe, el objeto Health. El comando oficial inspect permite inspeccionar objetos y formatearlos; no es una prueba de que la aplicación cumpla su contrato de negocio. docker compose ps -a revela contenedores terminados que desaparecerían de una vista de solo ejecutándose.
docker compose config ofrece una representación efectiva del archivo, pero puede exponer valores sensibles interpolados de variables. Para revisar solo nombres, --services minimiza esa exposición; si se investiga un valor concreto, hacerlo en un entorno autorizado y redactar los registros. Los logs también pueden contener tokens, direcciones y datos personales. Su recopilación es una acción de lectura desde la API de Docker, no autorización para difundirlos.
Un orden razonable de interpretación es síntoma → timestamp → proceso → recurso → dependencia, antes de realizar un redeploy. Por ejemplo, que la API informe connection refused a una base podría indicar que el destino no escucha, que usa un hostname incorrecto o que ambos servicios están en redes distintas. Reiniciar la API no discrimina esas hipótesis.
Un caso continuo: API, PostgreSQL y proxy
Consideremos una API HTTP que se conecta a PostgreSQL en una red definida por Compose. El ejemplo siguiente es una topología conceptual; no es un archivo de producción porque faltan imágenes fijadas por digest, secretos, comprobaciones de salud, límites y política de backups.
services:
  api:
    image: registry.example.invalid/tienda-api:demostracion
    environment:
      DATABASE_HOST: db
      DATABASE_PORT: "5432"
    ports:
      - "127.0.0.1:8080:8080"
    depends_on:
      - db
  db:
    image: postgres:18
    volumes:
      - datos_pg:/var/lib/postgresql
volumes:
  datos_pg:
La imagen registry.example.invalid es intencionalmente inexistente: sirve para explicar configuración, no para levantar el proyecto literalmente. Asimismo, depends_on en su forma corta establece un orden de arranque, no demuestra que PostgreSQL esté listo para aceptar transacciones. Ese contrato debe definirse con un health check apropiado, migraciones y reintentos controlados del lado de la aplicación. La referencia de Compose distingue service_started de service_healthy.
Paso 1: ¿qué está escuchando y dónde?
En la red de Compose, el nombre db puede resolverse a la dirección del contenedor PostgreSQL porque se utiliza el DNS incorporado en redes definidas por el usuario. El puerto 5432 es interno; no necesita estar publicado en el host para que lo use api. En cambio, 127.0.0.1:8080:8080 publica la API solo en la interfaz loopback del host bajo condiciones de red compatibles. No convierte el servicio en público ni implica que un proxy remoto pueda alcanzarlo.
# Puertos publicados en el host: no incluyen necesariamente puertos internos.
docker compose port api 8080
# Redes y direccionamiento desde la perspectiva del runtime.
docker inspect --format '{{json .NetworkSettings.Networks}}' CONTAINER_ID
# Configuración de los puertos declarados y sus bindings.
docker inspect --format '{{json .HostConfig.PortBindings}}' CONTAINER_ID
Hay al menos cuatro pruebas independientes: (1) el proceso escucha en 0.0.0.0:8080 o en la interfaz correcta dentro de su contenedor; (2) api puede resolver y contactar a db:5432; (3) el host puede conectar al puerto publicado; (4) un cliente externo puede atravesar DNS, firewall y, si corresponde, reverse proxy y TLS. Que funcione una no demuestra las demás. Véase Docker networking y port publishing.
Para observar listeners y realizar pruebas de red sin modificar la imagen, podemos utilizar herramientas ya presentes en ella o un contenedor diagnóstico autorizado en la misma red, documentando su configuración y permisos. docker exec no es el primer paso: una imagen distroless puede no incluir shell, curl ni ss. Además, ejecutar procesos altera temporalmente el entorno y puede exigir privilegios adicionales. No se debe introducir software nuevo en el contenedor productivo solo para hacer una comprobación.
Paso 2: ¿el health check mide lo que creemos?
Un contenedor puede estar healthy porque responde a /health, mientras que las consultas SQL fallan por credenciales o migraciones. También puede estar unhealthy porque su check invoca curl en una imagen sin curl. Separar liveness, readiness y una prueba externa evita el diagnóstico circular. Revisar en inspect tanto la definición efectiva como el historial de Health.Log, si está disponible, y comparar con una petición desde la misma frontera de red en que falla el consumidor.
RestartCount o Restarting altos son síntomas: hay que correlacionarlos con exit code, logs, eventos y cambios de despliegue. Un restart policy reduce indisponibilidad para fallos transitorios; puede ocultar un error persistente si solo se mira docker ps.
Recursos: CPU, memoria, disco y límites
docker stats ofrece una ventana de consumo y docker inspect revela límites configurados. Conviene diferenciar la memoria observada por la herramienta, la contabilización de page cache, los límites por cgroup y la memoria efectiva del host. Un pico de CPU puede ser procesamiento útil; una caída de rendimiento sin CPU alta también puede indicar espera por disco, red o locks de base de datos.
docker stats --no-stream
docker inspect --format '{{json .HostConfig.Memory}}' CONTAINER_ID
docker system df
# En un host Linux con permisos: contrastar además con las métricas del sistema.
docker system df consulta uso de disco; no es docker system prune. No ejecutes limpiezas automáticas como respuesta inicial: podrían retirar imágenes necesarias para rollback o borrar recursos que no entendiste. Si aparece OOMKilled=true, la hipótesis de falta de memoria gana fuerza, pero todavía hay que correlacionar el límite cgroup, la presión del host y el workload. Las métricas de Docker explican este modelo.
Persistencia: un directorio no es necesariamente un volumen
Una aplicación puede escribir en /app/uploads dentro de la capa del contenedor y perder esos archivos tras recrearlo. Otra puede montar un volumen sobre una ruta que ya tenía contenido en la imagen y «ocultarlo». Una base de datos puede conservar el volumen local y aun así no tener un backup recuperable si se pierde el host.
Antes de cualquier cambio de volumen:
docker inspect --format '{{json .Mounts}}' CONTAINER_ID
docker volume ls
# Inspeccionar un volumen concreto cuyo nombre ya fue confirmado.
docker volume inspect NOMBRE_DEL_VOLUMEN
Tres preguntas deciden la estrategia de recuperación: ¿qué proceso escribe?, ¿en qué ruta del contenedor? y ¿qué objeto físico respalda esa ruta?. Registrar el Source, Destination, tipo de mount y permisos de lectura/escritura evita confundir un bind mount con un volumen administrado. Los volúmenes no sustituyen copias consistentes de datos, pruebas de restauración ni snapshots coordinados.
Si un problema empezó después de cambiar una imagen, el rollback de código no garantiza la reversibilidad de una migración de base de datos. Un respaldo probado y un contrato compatible entre versiones siguen siendo necesarios. Este límite se desarrolla también en Coolify: responsabilidades de operación.
Qué añade Lazydocker y qué no
Lazydocker reúne en una interfaz de terminal listas de contenedores, servicios e imágenes, vistas de logs y gráficos de consumo. Es útil cuando correlacionamos varios servicios y necesitamos navegar entre ellos con rapidez. Se ejecuta como cliente de Docker, no como un sustituto del daemon, del host ni de Compose; la autoridad y el acceso dependen del socket y credenciales usados.
| Uso | Lazydocker | CLI / otros instrumentos |
|---|---|---|
| Reconocer servicios y explorar logs | Excelente para triage interactivo | docker compose ps, logs, events son reproducibles en notas |
| Inspeccionar configuración precisa | Vista general, según versión | docker inspect y docker compose config permiten capturar el dato exacto |
| Buscar una causa de OOM o de I/O | Pistas visuales | Cgroup/host metrics, logs, trazas y almacenamiento requieren otras señales |
| Ejecutar acciones | Existen controles que cambian estado | Exigir autorización y plan de recuperación tanto en UI como en CLI |
La configuración oficial y sus keybindings deben revisarse por versión. Algunos indicadores dentro de un contenedor pueden ser incompletos cuando se ejecuta Lazydocker él mismo como contenedor; la herramienta documenta limitaciones de logs y CPU en esa modalidad. No hay benchmark en este artículo que demuestre que una interfaz sea más rápida que otra.
La práctica recomendable es usar la TUI para localizar un síntoma y anotar la evidencia exacta en comandos e identificadores verificables: timestamp, contenedor, imagen por digest, configuración de red y volumen, versión del daemon, tipo de fallo. Una captura de pantalla aislada es difícil de reproducir o auditar.
Seguridad durante el diagnóstico
Pertenecer al grupo docker puede otorgar permisos equivalentes a root sobre el host. No hay una separación automática entre «solo quiero ver logs» y «tengo autorización para administrar cualquier contenedor»: depende de la arquitectura de acceso. Docker documenta esta implicación y ofrece Rootless Mode como alternativa bajo requisitos específicos, con diferencias de cgroups y redes a evaluar.
No hace falta --privileged, montar directorios sensibles del host o desactivar seccomp/AppArmor/SELinux para observar un fallo habitual de aplicación. Si una herramienta de depuración lo solicita, habría que explicar qué dato falta y qué autorización explícita existe antes de elevar privilegios. Tampoco se deben enviar logs completos con secretos a chats, issues públicos o servicios de terceros.
El principio también aplica a comandos de aparente comodidad: down -v, prune, rm y otras operaciones destructivas no forman parte del primer recorrido. No mezclar recolección de evidencia con remediación evita borrar precisamente la información necesaria para explicar el incidente.
Playbook: del reporte de incidente a la acción
- Delimitar el impacto. Servicio, primera hora conocida, usuarios afectados y cambios recientes; no asumir que el fallo se origina en el último deploy.
- Congelar evidencia.
ps -a, logs acotados,inspect, eventos y configuración efectiva con datos sensibles redactados. - Formar hipótesis por frontera. Proceso, dependencias, red, proxy, recursos, disco y mounts. Elegir una comprobación con resultado que pueda refutar cada hipótesis.
- Probar sin alterar. Preferir observación y endpoints de solo lectura. Si hay que modificar algo, definir primero impacto, reversión y autorización.
- Corregir la causa. Cambiar una variable o componente a la vez, con registro de versión y configuración; evitar «reiniciar todo» como prueba.
- Verificar desde fuera. Probar la solicitud que fallaba, además del estado interno y del health check. Confirmar integridad y persistencia cuando corresponda.
- Documentar prevención. Señal faltante, alerta, test o runbook; incluir qué no se pudo observar.
Laboratorios propuestos — sin resultados medidos
| Caso | Variable controlada | Señal discriminante | Estado |
|---|---|---|---|
| Proceso termina al iniciar | Comando/variable inválida en servicio ficticio | Exit code + logs + eventos | Propuesto, NO ejecutado |
| Listener vinculado a loopback interno | Bind de aplicación | Conexión interna vs publicación | Propuesto, NO ejecutado |
| DNS entre redes Compose | Network attachment | Resolución de nombre y ruta | Propuesto, NO ejecutado |
| Readiness antes de que arranque DB | Tiempo de disponibilidad | Health + primer acceso real | Propuesto, NO ejecutado |
| Presión de memoria | Límite cgroup en laboratorio | OOMKilled y métricas | Propuesto, NO ejecutado |
| Escritura sin volumen | Mount declarado vs ausente | Estado antes/después de recrear | Propuesto, NO ejecutado |
| Almacenamiento sin espacio | Cuota/disco de laboratorio | Error de escritura y métricas | Propuesto, NO ejecutado |
| Configuración divergente | Env efectiva e imagen | Valor deseado vs observado | Propuesto, NO ejecutado |
Cada protocolo necesita entorno recuperable, versiones y fecha, logs redactados, éxito/fracaso de las hipótesis y resultado explícito. La guía se puede aplicar con Docker CLI o Lazydocker en un proyecto aislado, nunca provocando fallos sobre servicios de terceros o producción.
Cierre: primero evidencia, después controles
Depurar contenedores deja de ser una colección de «comandos salvadores» cuando se practica como diagnóstico de sistemas. Docker ofrece estado, redes, mounts, eventos y métricas; Lazydocker reduce la fricción de navegar esas señales, pero no agrega información mágica ni sustituye una evaluación del host y de la aplicación.
La siguiente capa de aprendizaje es convertir una sesión de diagnóstico en un experimento repetible, con el mismo cuidado que se aplica a los entornos declarativos: entradas registradas, pasos acotados y conclusiones respaldadas por observaciones.
Referencias primarias
- Docker: overview y arquitectura.
- Docker: inspect, logs, events y port publishing.
- Docker: volúmenes, métricas y Rootless Mode.
- Lazydocker: repositorio, configuración y keybindings.


