
La clave de un mensaje en Kafka no es solo un identificador para agrupar datos. En un producer particionado, puede determinar qué registros comparten un log ordenado, cómo se distribuye el trabajo y qué límites aparecen cuando crece el número de consumidores. Diseñar esa clave sin entender la garantía de orden es una forma de introducir bugs de concurrencia que después parecen fallos del broker.
Este artículo se centra en Apache Kafka 4.4.0 y en el particionador del cliente Java cuando se indica expresamente. No he ejecutado aquí pruebas de carga; el laboratorio final es una propuesta reproducible. El ejemplo original asociaba una clave a un consumidor fijo y suponía que un dispositivo tendría su propia partición. Ambas simplificaciones son incorrectas: muchos dispositivos comparten particiones, y un rebalance puede cambiar el miembro que las consume.
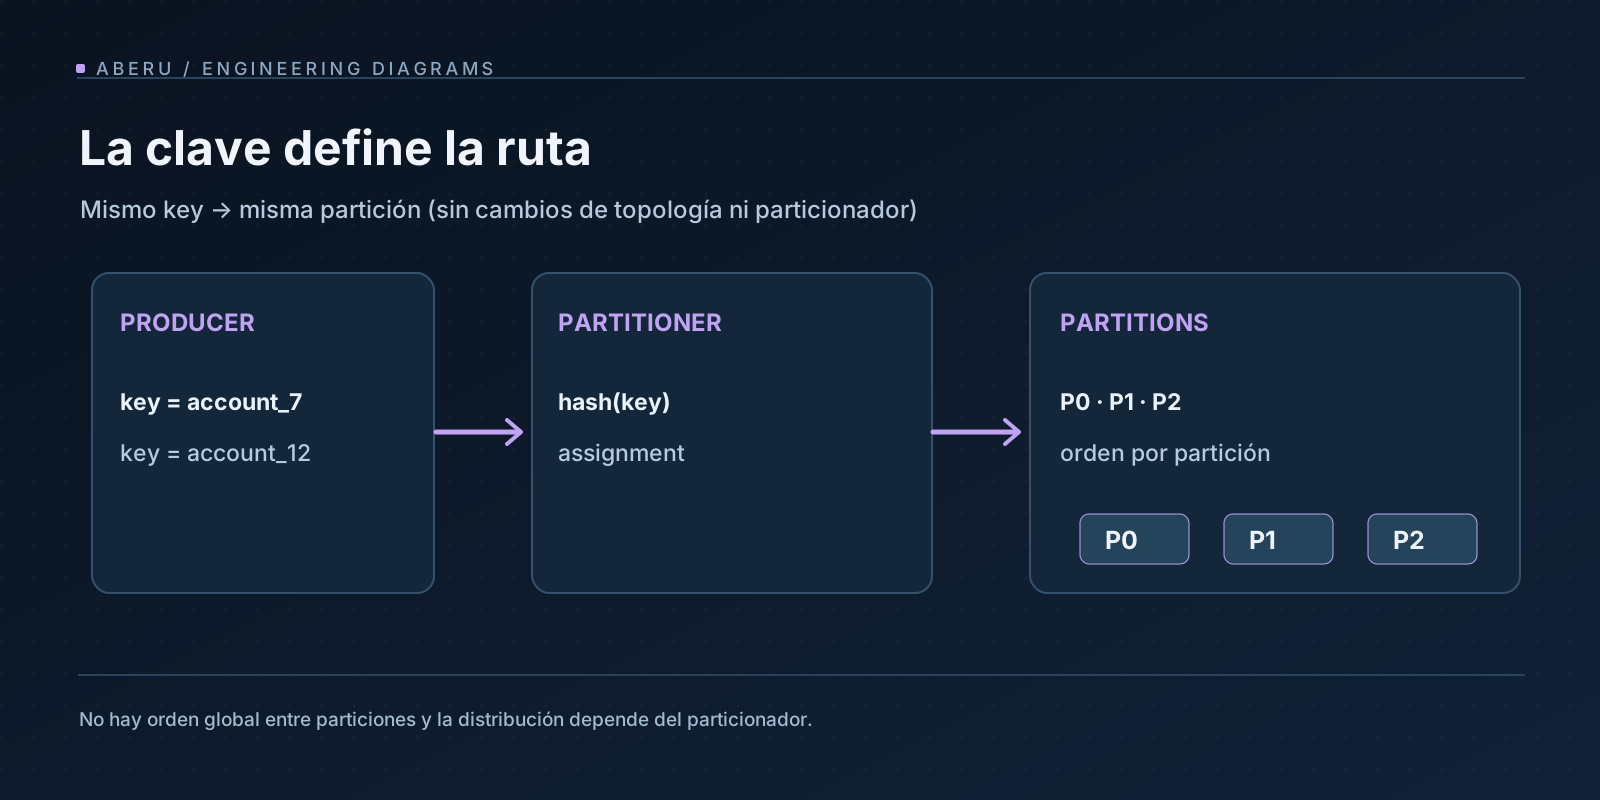
La partición es el dominio de orden, no la entidad de negocio
Un topic almacena registros por partición con offsets crecientes. Kafka garantiza el orden de lectura dentro de una partición, no un orden total entre todas las particiones de un topic. Dos eventos que caen en particiones distintas no tienen un orden global comparable solo porque sus timestamps sean similares.
Para una misma clave, una estrategia estable de particionado generalmente la dirige a la misma partición mientras no cambien el número de particiones, el particionador ni su configuración. Eso crea una base para procesar eventos de una entidad en orden, siempre que los producers también preserven el orden de envío de esos eventos. No resuelve automáticamente productores concurrentes, eventos históricos tardíos ni la causalidad entre servicios.
Un consumer group puede asignar cada partición a un único miembro activo del grupo en un momento dado. Si tenemos 12 particiones y 24 consumidores en el mismo grupo, no pueden existir 24 consumidores activos leyendo esas mismas particiones en paralelo. Si hay 100.000 entidades, no significa que haya 100.000 particiones: se distribuyen las entidades entre las particiones existentes.
Hashing: el detalle del cliente importa
Para mensajes con clave, el particionador integrado del producer Java, en su ruta clásica para keys, usa Murmur2 y asignación basada en el número de particiones. Una representación conceptual es:
partition = positive(murmur2(serialized_key)) % partition_count
Esta expresión resume el comportamiento correspondiente: no implementa el algoritmo, no equivale a un hash criptográfico y no debe copiarse como código ejecutable ni asumirse para todo SDK. La serialización de la key forma parte de la entrada al hash; userId=42 como string UTF-8 no produce necesariamente el mismo resultado que un entero serializado en binario. Algunas bibliotecas no Java y particionadores personalizados tienen convenciones distintas. Hay que comprobar sus implementaciones y casos de prueba antes de mezclar producers.
La elección para registros con null key depende del producer y puede involucrar mecanismos de particionado orientados a batches: no es correcto afirmar que siempre usa round-robin. En todo caso, no hay afinidad estable por entidad basada en una key que no existe.
Documentación: Kafka producer configs 4.4, Kafka operations.
Definir las invariantes antes de elegir orderId
Considera una plataforma que registra eventos OrderCreated, PaymentAuthorized, OrderPacked y OrderShipped. Si la lógica requiere reconstruir un pedido aplicando sus eventos en orden, orderId es una candidata natural para la key.
{
  "event_id": "evt-0007",
  "aggregate_type": "order",
  "aggregate_id": "order-1092",
  "aggregate_version": 4,
  "event_type": "OrderPacked",
  "occurred_at": "2026-11-17T10:00:00Z"
}
El JSON es dato sintético ilustrativo. Si el producer publica usando aggregate_id como key, todos los eventos de ese agregado pueden compartir partición y preservar el orden de append, dadas las condiciones anteriores. aggregate_version sirve como defensa lógica: el consumidor puede detectar un salto de versión o un evento duplicado aunque el transporte haya sido alterado por un retry o un replay.
La key se decide por el dominio de serialización necesario:
| Candidata | Qué orden reúne | Riesgo o límite |
|---|---|---|
orderId | Eventos de un pedido | Un pedido excepcionalmente activo crea una hot key |
accountId | Movimientos de una cuenta | Una cuenta popular puede concentrar tráfico |
userId | Eventos de un usuario | Usuarios desiguales generan skew |
deviceId | Telemetría de un dispositivo | Una flota con dispositivos muy activos no queda equilibrada |
country | Eventos por país | Cardinalidad baja y distribución demográfica desigual |
| Sin key | Ningún orden por entidad | Requiere diseño sin afinidad por clave |
Una clave de alta cardinalidad no garantiza una distribución uniforme de bytes, CPU o coste de procesamiento. Un único userId con millones de eventos por minuto puede saturar una partición incluso si existen millones de usuarios inactivos.
Skew: el problema es la tasa y el coste, no solo contar claves
Separa tres fenómenos:
- Skew de keys: distribución no uniforme de registros entre entidades.
- Skew de particiones: distribución de bytes o eventos desigual después del hash y el número de particiones.
- Skew de procesamiento: una partición consume más CPU/I/O por evento aunque reciba menos mensajes.
Para diagnosticar, registra por partición bytes in/out, tasa de mensajes, tamaño de batches, latencia del producer y el lag por partición y grupo. Un lag alto puede deberse a un sink lento o a un consumer desbalanceado, no necesariamente a una key incorrecta.
Ejemplo hipotético, no medición:
partición 0 → 15 % de eventos, 40 % del coste de procesamiento
partición 1 → 10 % de eventos,  8 % del coste
partición 2 → 75 % de eventos, 52 % del coste
Una distribución perfecta de registros no equivale a un balance perfecto de trabajo. El percentil de latencia de extremo a extremo es otro eje: una hot key puede bloquear eventos posteriores de la misma partición aunque la cola total parezca manejable.
¿Por qué no añadir particiones sin más?
Supón que inicialmente un topic tiene N = 12 particiones. Si aumenta a 24, la operación hash(key) % N puede asignar la misma key a una partición distinta. Kafka no mueve automáticamente el historial de la partición antigua a la nueva. Durante un periodo de transición, eventos de la misma entidad pueden quedar en dos particiones distintas: dos consumidores podrían procesar las dos secuencias sin una barrera de orden global.
El problema no es solamente que una key cambie de sitio. El problema es que la invariancia «todos los eventos de un pedido están en una sola secuencia» deja de ser cierta a lo largo de la vida del topic si se interpreta sin condiciones.
Para un sistema que depende estrictamente de orden por entidad, un cambio de particiones requiere un plan de migración. Las opciones conceptuales incluyen producir a un nuevo topic con particionado explícito, construir un corte de tráfico controlado, esperar un drenaje verificable o versionar la asignación para manejar transiciones. La opción correcta depende de la posibilidad de pausar producers, del volumen, del replay y de los SLA de disponibilidad.
No existe una receta de «duplicar particiones en producción sin impacto» que sea válida para todas las aplicaciones. Fuente: Kafka operations.
Salting de claves: paralelismo a cambio de garantías
Una hot key puede motivar repartir eventos en múltiples claves sintéticas, por ejemplo accountId#bucket. El beneficio potencial es distribuir carga; el coste es romper el orden único por cuenta.
# Representación de diseño, no receta recomendada por defecto
account-4#0
account-4#1
account-4#2
El hash ahora reparte subflujos que antes eran uno. Si una operación requiere aplicar movimientos de una cuenta en secuencia, el salting no es seguro sin un protocolo adicional de secuenciación, conciliación o partición por unidades realmente independientes. Se puede utilizar cuando las operaciones son conmutativas o agregables, o cuando las claves compuestas representan subdominios cuyo orden es independiente.
Antes de repartir una clave caliente conviene evaluar otras opciones: mejorar el coste del handler, sacar trabajo pesado de la ruta secuencial, agrupar operaciones, aumentar la capacidad por partición o rediseñar el agregado de negocio. Más paralelismo no es gratis si sacrifica corrección.
Orden de escritura: producer, retries e idempotencia
La afinidad por key no basta si el producer introduce reordenamiento. En versiones modernas del producer Java, la idempotencia es compatible con max.in.flight.requests.per.connection de hasta 5, con acks=all y reintentos habilitados. En ese rango se conserva el orden del producer idempotente. En cambio, si se deshabilita la idempotencia y se permiten múltiples requests en vuelo con retries, un envío que falla y se reintenta puede quedar detrás de otro envío posterior que llegó primero.
# Ejemplo deliberadamente explícito para estudiar ordering
acks=all
enable.idempotence=true
max.in.flight.requests.per.connection=5
No es un mecanismo de orden global entre múltiples productores. Si dos procesos actualizan simultáneamente el mismo agregado, el broker ordena su llegada, pero no sabe cuál operación de negocio debería ocurrir primero. En esos casos se necesitan precondiciones y versiones de agregado, concurrencia optimista, una autoridad de secuenciación o un modelo equivalente.
Apache Kafka: producer configuration.
Consumers: partición, offsets y rebalances
El consumidor recibe registros y confirma offsets según su estrategia de procesamiento. Un commit de offset no confirma que un servicio externo haya aplicado correctamente el cambio. Si el proceso falla después de escribir en la base de destino pero antes de confirmar el offset, Kafka puede entregar el mismo evento otra vez. Si confirma antes de persistir, un crash puede hacer que la aplicación pierda el efecto.
Por eso un handler robusto suele combinar un identificador único de evento, una operación idempotente en el destino, una transacción local cuando corresponda y una política clara de retry/DLQ. Los eventos fuera de orden, duplicados y poison messages requieren tratamiento distinto.
Tampoco se promete que «misma key = mismo consumer para siempre». Los rebalances cambian asignaciones; la garantía relevante es que una partición pertenece, en condiciones normales, a un miembro activo por consumer group y que el procesamiento correcto preserva el orden necesario.
Laboratorio reproducible: propuesto, no ejecutado
El experimento debería generar datos sintéticos con semilla fija y publicar un conjunto conocido de eventos. No hay throughput, CPU ni p99 medidos en este artículo.
- Fijar Kafka 4.4, versión del cliente, serializers, acks, idempotencia, particiones, hardware y replication factor.
- Comparar keys uniformes con distribución Zipfian y un heavy hitter; contar asignaciones antes de lanzar consumidores.
- Medir registros/segundo, bytes por partición, lag máximo, p95/p99 por evento y memoria del grupo.
- Repetir con 12, 48 y 192 particiones, sin confundir escalabilidad del consumidor con la de un productor.
- Simular un rebalance en laboratorio y verificar conservación de orden por agregado y deduplicación.
- Analizar por separado un cambio del número de particiones con consumidores drenados: registrar keys remapeadas y sus offsets históricos.
- Documentar qué resultados invalida un cambio del algoritmo de hashing o del serializer.
El reporte debería incluir la distribución completa de particiones, no solo el promedio. Un resultado en el que el sistema publica rápidamente pero una sola partición acumula todo el lag revela una limitación real de diseño.
Conclusión: una key representa un contrato de orden
Las particiones no son una técnica abstracta para «escalar Kafka». Son una decisión sobre qué necesita permanecer junto, qué puede ejecutarse en paralelo y qué sucede cuando cambia la topología.
El criterio práctico es: formular primero la invariancia del agregado, probar la distribución con datos representativos y documentar la migración antes de aumentar particiones. Para comparar el broker que ejecuta ese diseño, consulta Redpanda vs Kafka: arquitectura, compatibilidad y coste operativo.
Fuentes principales
- Apache Kafka 4.4: documentación y configuración
- Kafka: operaciones y particiones
- ProducerConfig 4.4 (API Java)
- Kafka: semánticas de entrega


