
Que dos brokers acepten clientes del protocolo Kafka no significa que sean la misma plataforma. Tampoco significa que uno gane siempre en rendimiento. La decisión real afecta al diseño de persistencia, a las garantías de escritura, al control del clúster y a la carga del equipo que lo opera.
Este artículo actualiza la comparación original para Apache Kafka 4.4.0 y Redpanda 26.2, con documentación consultada en noviembre de 2026. No he ejecutado aquí un benchmark ni desplegado ambos productos en producción. El texto anterior atribuía una prueba de un millón de eventos por segundo y mejoras de CPU/latencia sin datos verificables: esas cifras se eliminan. También afirmaba erróneamente que Kafka necesita ZooKeeper; Kafka 4.x funciona con KRaft.
La pregunta útil no es «¿cuál es más rápido?», sino «¿qué garantías, compatibilidades y costes operativos necesito para este flujo?».
Antes de comparar: qué hace un broker de eventos
Un producer publica registros en un topic. El topic se divide en partitions, que son logs ordenados de registros. Los consumidores leen offsets dentro de esas particiones; un consumer group puede repartirlas entre sus miembros. La retención permite releer datos mientras sigan disponibles. La replicación ofrece tolerancia a fallos bajo condiciones específicas, pero no sustituye backups, recuperación probada o controles de retención.
Una partición es simultáneamente una unidad de orden y una unidad relevante de paralelismo. Si una clave concentra todo el tráfico en una sola partición, agregar consumidores no puede repartir su procesamiento dentro de ese group. Ese problema de modelo se desarrolla en Kafka: diseñar claves de partición sin romper el orden.
Los sistemas pueden compartir esta interfaz visible y diferir enormemente en cómo implementan el plano de control, replicación, caché y ejecución.
Kafka 4.4: KRaft, brokers y logs segmentados
Kafka persiste registros en segmentos de log en el filesystem. Se apoya en page cache, batching, compresión y mecanismos del sistema operativo como sendfile cuando la ruta de transferencia lo permite. No se debe reducir su rendimiento a «estar escrito en Java»: red, disco, configuración y patrón de acceso importan tanto como el runtime.
En Kafka 4.x, ZooKeeper ya no es un modo de operación. KRaft utiliza un quorum de controladores que mantiene la metadata del clúster mediante un log replicado. Las particiones de datos mantienen sus líderes y réplicas, mientras el quorum de metadata coordina los cambios de estado. No son la misma capa.
La distinción también importa al diagnosticar fallos: pérdida de conectividad con un controller, ISR insuficiente, presión del disco de un broker y retraso de consumidores son incidentes distintos. Un clúster correctamente desplegado no equivale a un sistema sin intervención humana.
Consumer groups: el protocolo también tiene versión
Kafka 4.4 incluye el protocolo tradicional classic y el protocolo consumer asociado a KIP-848, que alcanzó disponibilidad general en Kafka 4.0. El nuevo protocolo elimina la barrera global de sincronización del rebalance clásico y desplaza al servidor parte de la gestión de heartbeats, tiempos y asignaciones.
Esto no significa que todos los clientes vayan a usarlo automáticamente: depende de la versión, de la configuración del cliente y del broker. Si se comparan tiempos de rebalance, el protocolo efectivo y la estrategia de asignación deben constar en los resultados. KIP-848 y la documentación de Kafka son las referencias para estas diferencias.
Redpanda 26.2: ejecución por núcleo y consenso Raft
Redpanda implementa el protocolo Kafka desde una arquitectura distinta: código nativo en C++, ejecución asíncrona mediante Seastar y diseño thread-per-core. Divide la ejecución y el acceso a memoria por shards para reducir la coordinación entre núcleos. Esto puede cambiar la forma de consumir CPU, tratar la latencia y dimensionar nodos, pero por sí solo no prueba una ventaja cuantitativa en cualquier carga.
En Redpanda, cada partición de datos actúa como un grupo Raft y existe además una partición controladora replicada para la metadata. Compararlo con KRaft requiere distinguir el Raft de metadata de Kafka del uso que Redpanda hace de Raft para el log de cada partición.
No hay un proceso ZooKeeper externo en Redpanda, pero tampoco en Kafka 4.4. La diferencia operacional real incluye topología de nodos, memoria reservada, monitoreo, convenciones de despliegue, compatibilidad de herramientas y disponibilidad de funciones licenciadas.
Referencias: Redpanda: architecture y release notes 26.2.
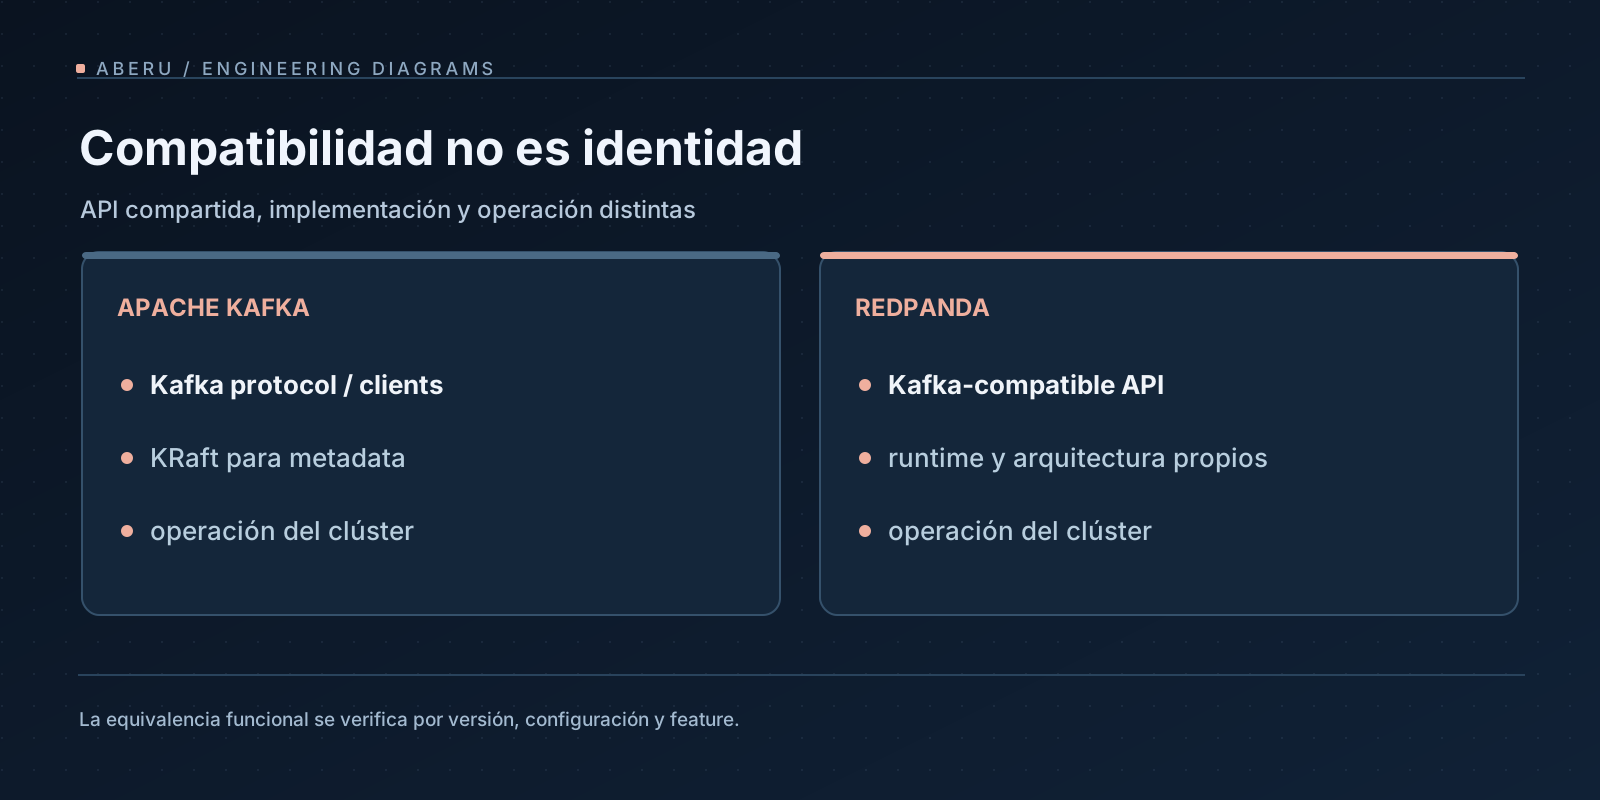
Una API ampliamente compatible no es semántica idéntica
Redpanda puede atender producers y consumers de la familia Kafka y valida clientes recientes, pero la compatibilidad exige mirar operación por operación. Un cliente que publica y consume correctamente no demuestra que otro componente de la plataforma se comporte igual.
Un ejemplo concreto es min.insync.replicas. Kafka utiliza este ajuste, junto con acks=all, en su política de aceptación de escrituras según el número de réplicas sincronizadas. Redpanda acepta la opción por compatibilidad, pero no la implementa con el mismo efecto: con acks=all, confirma después de que una mayoría de réplicas de la partición tenga el registro, independientemente del valor configurado en min.insync.replicas.
Otras diferencias documentadas afectan cuotas, mecanismos de autenticación, APIs especializadas y detalles del protocolo de transacciones. Redpanda 26.2 indica, por ejemplo, que los clientes Kafka 4.x pueden usar el protocolo de transacciones anterior cuando la versión más reciente no esté disponible. La lista exacta cambia por versión: matriz oficial de compatibilidad.
Prueba de compatibilidad propuesta: antes de migrar, ejecutar sobre ambos destinos los mismos casos de producción, consumo, transacción, autenticación, rebalance, esquema y fallo de broker, y conservar las respuestas y configuraciones relevantes. «La API conecta» es apenas la primera comprobación.
Durabilidad y orden: especificar antes de optimizar
No existe una única opción llamada «escritura segura». Para cada flujo hay que describir el factor de replicación, el requisito de confirmación, la política ante réplicas no disponibles y el riesgo aceptable de pérdida o duplicación.
En Kafka, un producer con idempotencia necesita acks=all, retries habilitados y un máximo de cinco requests in flight por conexión. Dentro de esos límites, no hace falta fijar max.in.flight=1 únicamente para mantener el orden del producer idempotente. Si se desactiva la idempotencia y hay reintentos con más de una request en vuelo, puede producirse reordenamiento tras un error. Es una propiedad concreta de protocolo/cliente, no una garantía de negocio end-to-end.
# Ejemplo de parámetros Kafka Producer, no configuración universal de clúster
acks=all
enable.idempotence=true
retries=2147483647
max.in.flight.requests.per.connection=5
compression.type=zstd
linger.ms=10
Este fragmento no se ha probado contra un broker en esta investigación. Para adoptarlo hay que revisar el timeout total, el throughput objetivo, latencia aceptable, compresión disponible y versiones de cliente. La configuración del broker determina otros límites. Fuente: Kafka producer configuration.
Las transacciones de Kafka pueden coordinar escritura y offsets consumidos dentro de Kafka. Una notificación enviada a una API externa, un cobro procesado por un tercero o una escritura en otra base de datos no hereda automáticamente exactly-once. El artículo sobre pipelines del Bloque 06 desarrolla los patrones de outbox, idempotencia y replay cuando ese texto se publique.
Schema Registry y ecosistema: evaluar capacidades concretas
Kafka dispone de un ecosistema amplio: Kafka Connect, Kafka Streams, clientes, herramientas de observabilidad y registries. No todo ese ecosistema forma parte del binario de Apache Kafka, y conviene distinguir proyectos Apache, servicios comerciales y complementos autogestionados.
Redpanda tiene componentes e integraciones de su plataforma, incluido soporte relacionado con Schema Registry; afirmar que siempre necesita montar un registro ajeno o que Kafka lo incluye de serie sería incorrecto. La comparación exige fijar qué producto, edición, API de esquema y política de compatibilidad se necesita. En un contrato Avro/Protobuf/JSON Schema se deben probar cambios de esquema compatibles e incompatibles, no simplemente verificar que exista un endpoint.
También hay que mirar cómo se despliegan, escalan y recuperan conectores, quién almacena sus offsets y qué SLA tiene el ecosistema en la edición contratada.
Licencias y capacidad operacional
| Dimensión | Apache Kafka 4.4 | Redpanda 26.2 |
|---|---|---|
| Núcleo | Java/Scala, brokers y controladores KRaft | C++/Seastar, ejecución por shard y Raft |
| Metadata de clúster | Quorum de controladores KRaft | Partición controller replicada |
| Logs de datos | Segmentos en filesystem; replicación por partición | Logs por partición replicados mediante Raft |
| Clientes Kafka | Implementación de referencia del protocolo | Compatibilidad extensa, con excepciones documentadas |
| Licencia base | Apache-2.0 | Community bajo BSL; Enterprise con condiciones adicionales |
| Funciones comerciales | Dependen de la distribución/servicios elegidos | Algunas capacidades requieren Enterprise |
La edición Community de Redpanda no debe describirse indistintamente como Apache-2.0. Determinadas capacidades, como almacenamiento por niveles, shadowing o controles avanzados, pueden depender de edición o licencia: verificar la documentación oficial de licenciamiento. Los precios y restricciones contractuales varían y aquí no se han inventado costes mensuales.
El TCO no es solo el precio de nodos: incluye provisión, almacenamiento, soporte, personal de guardia, upgrades, compliance, backup, recuperación, cambios de versión y operación de la plataforma de esquemas y conectores. Que algo sea un único binario no lo convierte automáticamente en una operación de una sola pieza.
Cómo ejecutar una comparación medible
Un benchmark útil tiene hipótesis, configuración, métricas y controles. Un ensayo justo no impone ajustes idénticos si eso degrada artificialmente una arquitectura, pero sí documenta la intención equivalente y explica las diferencias.
| Variable | Qué registrar |
|---|---|
| Versiones | broker, cliente, driver, kernel, tipo de instancia |
| Infraestructura | CPU, RAM reservada, red, discos, filesystem, TLS/SASL |
| Topología | nodos, replication factor, partitions, controladores, placement |
| Productores | tamaño y distribución de claves, compresión, acks, batching, concurrencia |
| Consumidores | número de grupos, protocolo, velocidad, condiciones de backpressure |
| Ejecución | warm-up, duración, repeticiones, distribución de carga y pérdidas |
| Resultados | throughput útil, p50/p95/p99, CPU, RSS, disco, red, error rate, lag y recuperación |
Una matriz razonable propondría mensajes de 1 KiB y 16 KiB, 12/48/192 particiones, cargas uniformes y concentradas, productores con distintos niveles de batching y fallos controlados de líderes. Los ensayos están propuestos, no ejecutados. Deben detenerse de forma segura en un laboratorio aislado, nunca en un clúster real con datos de terceros.
Los resultados del benchmark histórico publicado por Redpanda comparaban versiones mucho más antiguas (Kafka 3.2.0 y Redpanda 22.2.2), en infraestructura y condiciones específicas. Son evidencia del fabricante, no una prueba independiente de qué ocurrirá hoy. Guía de OpenMessaging Benchmark de Redpanda.
Elegir con una matriz de decisión, no con una consigna
Si ya existe una infraestructura Kafka que cumple SLOs y el equipo sabe operarla, el coste de migración, las políticas de seguridad y la compatibilidad funcional probablemente importen más que una mejora especulativa de latencia. Si el sistema comienza de cero y el equipo valora una experiencia operativa concreta, Redpanda merece una prueba con su carga real y con límites de edición revisados.
Para cualquiera de los dos, la calidad de las partition keys y de los consumidores puede dominar el comportamiento del pipeline. Continúa por el análisis de particiones, distribución y orden.
El criterio final es falsable: elegir el que cumpla las garantías necesarias y los SLOs medidos con menor coste total y riesgo aceptable. Sin un experimento controlado, no hay ganador universal.
Fuentes principales
- Apache Kafka 4.4 / documentación oficial
- Kafka: diseño y almacenamiento
- KIP-848: nuevo protocolo de consumer groups
- Redpanda: arquitectura y fundamentos
- Redpanda: compatibilidad con clientes Kafka
- Redpanda: novedades 26.2
- Redpanda: información de licencias

