
Un conflicto parece mucho menos misterioso cuando dejamos de pensar en Git como una colección de verbos y empezamos a verlo como un sistema de objetos, snapshots y referencias. Lo mismo ocurre con un reset inesperado, un commit que debería dividirse en dos o una rama que sigue apuntando a una versión anterior. La pregunta útil no es «¿qué comando arregla Git?», sino «¿qué estado quiero cambiar y cuál necesito conservar?».
La tesis de este artículo es que trabajar con Git con seguridad consiste en identificar el límite de cada operación. Interfaces como Lazygit o tig pueden hacer visibles esos cambios, pero ninguna sustituye comprender el índice y las referencias que modifica por debajo. Los ejemplos se plantean para repositorios de laboratorio; no describen operaciones efectuadas sobre el repositorio del blog ni sobre trabajo ajeno.
La documentación oficial de Git y Pro Git son la referencia principal. Para el contexto de versiones del dossier, Git 2.56.1 era el release estable documentado; los principios de objetos y refs no dependen de memorizar ese número. Desde Git 2.51, git switch y git restore dejaron de llevar la advertencia de comandos experimentales, según las notas de la versión.
Cinco estados que conviene no mezclar
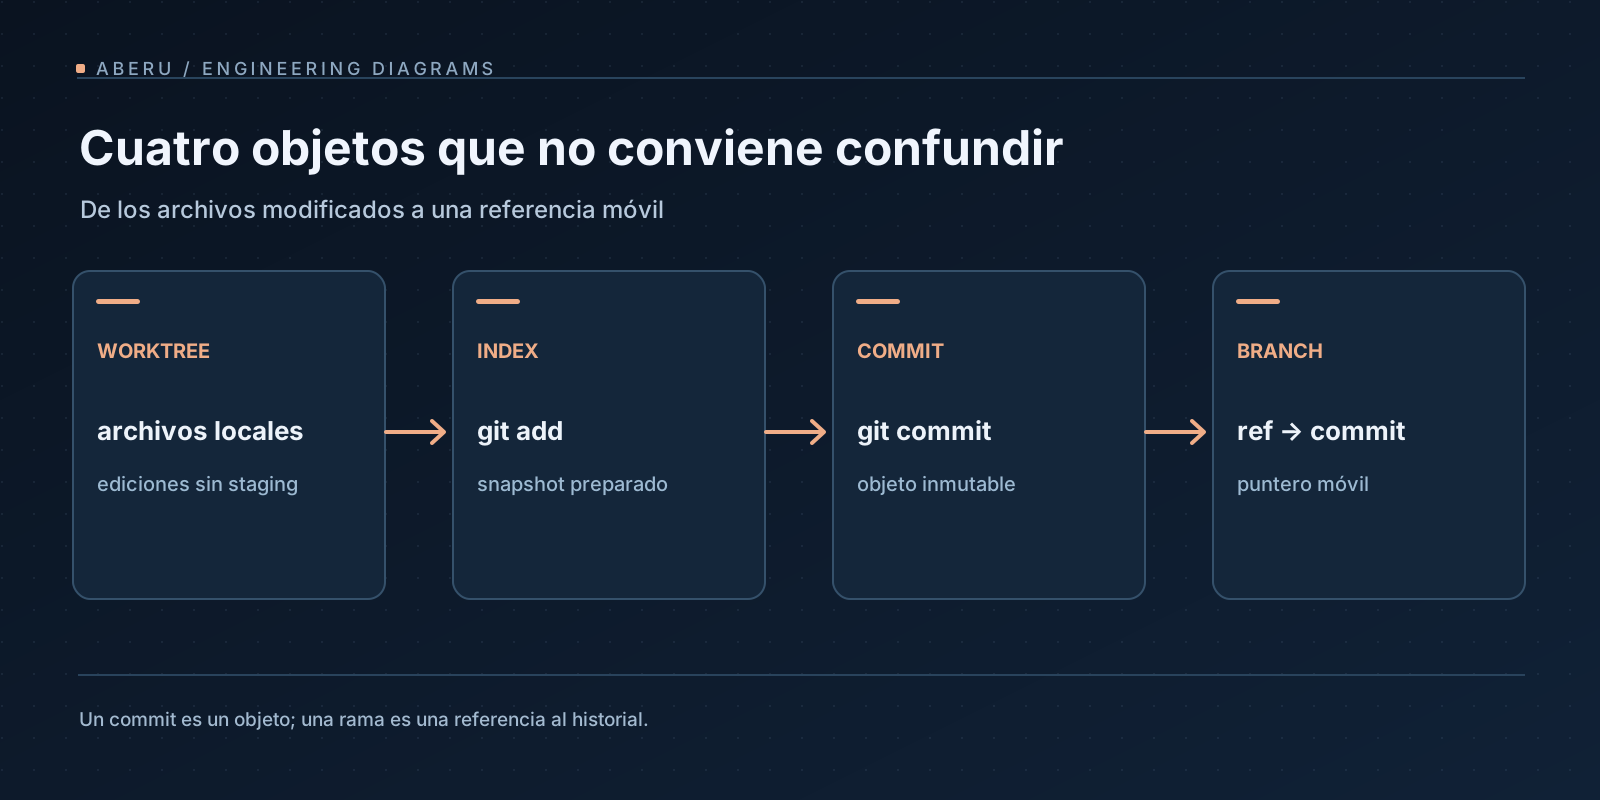
Imaginemos que la rama main apunta al commit C. Su árbol de archivos es un snapshot versionado. Cuando editas un archivo, no has cambiado automáticamente el commit C ni la rama: has cambiado el working tree. Cuando añades contenido para el próximo commit, actualizas el index o staging area. Al confirmar, Git crea objetos y mueve la referencia de la rama activa.
| Elemento | Significado | Pregunta que responde |
|---|---|---|
| Working tree | Archivos tal como están en el directorio de trabajo | ¿Qué tengo ahora mismo en disco? |
| Index | Versión preparada de los archivos para el próximo commit | ¿Qué incluirá exactamente el commit? |
HEAD | Referencia a la posición de trabajo actual, normalmente una rama | ¿Desde qué commit estoy trabajando? |
| Branch / ref | Nombre que apunta a un commit y puede avanzar | ¿Qué punto del grafo identifica esta línea de trabajo? |
| Objetos Git | Commits, trees y blobs almacenados por su identidad de contenido | ¿Qué snapshots e historial posee el repositorio? |
Un git add actualiza el índice; no es sinónimo de crear un commit. Un git commit escribe un nuevo snapshot y mueve la referencia asociada a HEAD. Y git switch cambia el contexto de la rama sin pedirte que reconstruyas el historial. Puedes inspeccionar estas diferencias sin riesgo en un repositorio de práctica:
# Ejecutar en un directorio nuevo dedicado al laboratorio.
git init -b main laboratorio-git
cd laboratorio-git
printf 'puerto=8000\nmodo=dev\n' > app.conf
git add app.conf
git -c user.name='Ejemplo' -c user.email='ejemplo@example.invalid' commit -m 'Agregar configuración inicial'

git status --short
git log --oneline --decorate -3
git ls-files --stage
El resultado concreto —hashes, timestamps e identidad del commit— depende del entorno y no se ha inventado como salida fija. git ls-files --stage permite observar la representación del índice; git log indica dónde apuntan las refs. Estos datos son más útiles que memorizar recetas de «deshacer».
Un commit debe ser una decisión, no solo un punto de guardado
Supongamos que editas en el mismo archivo una validación y un mensaje de error. Si esas modificaciones responden a causas diferentes, probablemente deban revisarse por separado. git add -p permite seleccionar fragmentos de un diff para el índice. Una alternativa visual es el staging por hunks o líneas de Lazygit, descrito en el repositorio del proyecto.
En el laboratorio anterior, prueba un cambio con dos grupos independientes:
printf 'puerto=8080\nmodo=dev\n' > app.conf
printf 'descripcion=entorno de prueba\n' >> app.conf
git diff -- app.conf
git add -p app.conf
git diff --cached -- app.conf
git diff -- app.conf
La secuencia interactiva depende de qué hunks detecte Git; cambios demasiado próximos pueden agruparse y requerir dividirlos desde el selector. El objetivo es comprobar que git diff --cached representa exactamente la propuesta de commit. La interfaz no decide la unidad lógica del cambio: quien revisa sí.
Esta práctica también reduce el riesgo de incorporar archivos temporales o configuraciones locales sensibles. Antes de publicar, git status, git diff --cached y la revisión de secretos forman parte de un control explícito, no de un ritual opcional.
Merge y rebase responden a preguntas distintas
Cuando dos ramas avanzan desde un ancestro común, merge crea una unión del historial sin alterar los commits originales de ambas ramas; cuando es necesario, esa unión toma la forma de un nuevo commit con múltiples padres. Rebase reconstruye commits sobre una base distinta y genera nuevas identidades para los commits reescritos.
No existe un ganador universal. Merge conserva con claridad la historia de integración de líneas de trabajo. Rebase puede simplificar una serie local antes de compartirla, a costa de cambiar identidades. La política correcta depende de colaboración, auditoría, facilidad de revisión y restricciones del repositorio. La explicación de branching y merging de Pro Git describe los tres puntos involucrados en un merge.
Conflicto no significa que Git haya perdido los cambios: significa que no puede decidir automáticamente cómo reconciliar modificaciones incompatibles. Durante una resolución, conviene inspeccionar qué archivo, qué base y qué versiones participan; git status señala el estado de integración y git diff muestra el contenido por resolver. La decisión semántica —qué comportamiento es correcto— sigue perteneciendo al desarrollador.
Reescribir antes de publicar; revertir después de publicar
Un git rebase -i permite reordenar o combinar commits propios antes de que otras personas dependan de ellos. No debería presentarse como operación automática sobre una rama compartida: reescribe hashes y rompe referencias externas a los commits anteriores.
Para un error ya publicado, git revert <commit> suele ser más apropiado: crea un nuevo commit que invierte el parche del anterior, conservando el hecho histórico de que ese cambio existió. git reset cambia la referencia y, dependiendo de --soft, --mixed o --hard, también el índice o el working tree. Esta diferencia es crucial: usar una opción que descarta cambios sin inspección puede eliminar trabajo no confirmado.
Antes de cualquier operación con pérdida potencial, conviene tener un árbol limpio, inspeccionar diffs y registrar una referencia de recuperación en el repositorio correspondiente. No se recomienda el force push como consecuencia automática de hacer rebase; depende de quién consume la rama, sus protecciones y la política del equipo. La documentación de git reset detalla qué parte del estado cambia con cada modo.
Reflog: un mapa local de las referencias, no un backup remoto
Git guarda registros locales de movimientos recientes de referencias: reflogs. Allí pueden encontrarse posiciones anteriores de HEAD o de una rama, incluso cuando el grafo visible ya no las presenta como punta actual. Por eso, después de un movimiento inesperado, suele ser mejor inspeccionar que ejecutar otra acción correctiva a ciegas:
git status
git reflog --date=iso
git show HEAD@{1}
La referencia HEAD@{1} significa la entrada anterior del reflog de HEAD en ese repositorio concreto; no identifica universalmente «el último commit bueno». Primero verifica el hash y el snapshot observado. Los reflogs son locales, tienen políticas de expiración y no sustituyen un remoto, un backup ni la recuperación de archivos que Git nunca registró. Consulta el manual git-reflog.
Este es el punto de partida para una recuperación responsable: observar las entradas, verificar el objeto deseado, crear una referencia recuperable y solo después decidir si mover una rama. El orden protege contra «arreglar» el problema equivocado.
Bisect: localizar un cambio con una hipótesis comprobable
Cuando una prueba funcionaba en un commit y falla en otro, revisar todo el historial línea a línea puede ser innecesario. git bisect guía una búsqueda entre estados conocidos, normalmente reduciendo el conjunto de candidatos por mitades.
Para usarlo correctamente necesitas al menos un commit bueno y uno malo, y una forma de clasificar un commit intermedio. En un clon o worktree de laboratorio:
# Primero identificar hashes reales mediante git log.
git log --oneline --max-count=12
# Ejemplo conceptual: reemplazar por hashes verificados en el repositorio.
git bisect start "$BAD_COMMIT" "$GOOD_COMMIT"
# Evaluar la prueba en cada checkout intermedio.
# git bisect good    # si la prueba pasa
# git bisect bad     # si la prueba falla
# Al terminar: git bisect reset
Las líneas con placeholders no son comandos listos para pegar: representan una plantilla de laboratorio. bisect es potente cuando la prueba es estable y el entorno de ejecución controla dependencias; una prueba intermitente puede producir una conclusión falsa. Como en cualquier herramienta de diagnóstico, la validez de la observación importa tanto como el algoritmo. El manual de git bisect incluye variantes automatizadas con un script que devuelve estados de éxito/fallo.
Worktrees: aislar contextos sin duplicar toda la historia
git worktree crea directorios de trabajo adicionales asociados al mismo repositorio, cada uno con su propia rama/HEAD, working tree e índice. Es apropiado cuando necesitas mantener abierta una tarea mientras pruebas un bugfix, revisas un PR o permites que una herramienta modifique código sin mezclar su diff con el tuyo.
Partiendo de un repositorio existente y con un directorio hermano libre:
git worktree list
git worktree add -b revision/bug ../revision-bug HEAD
git worktree list
La orden crea una rama de ejemplo y un directorio nuevo; no ejecuta tests ni concede permisos de sandboxing. Para retirar luego una worktree, comprueba primero que no contiene trabajo por conservar; la documentación de git worktree explica los estados bloqueados y las reglas de eliminación. Una worktree aislada conserva riesgos si ambos procesos usan los mismos secretos, dependencias externas o acceso de red.
En un flujo con agentes de IA, esa distinción será especialmente importante: el agente puede recibir una worktree propia, pero sigue necesitando límites de permisos, una revisión de diff y una política de aceptación. Git es un registro auditable; no es, por sí mismo, una sandbox de ejecución.
Lazygit y tig: dos interfaces sobre el mismo modelo
Lazygit prioriza operaciones interactivas: staging, commits, revisión de cambios, cherry-pick y rebase. Su guía de interactive rebase documenta esas transformaciones. En la investigación se verificó la release v0.66.3, del 7 de noviembre de 2026, pero una combinación de teclas de la UI no debería enseñarse sin comprobar la versión del lector.
tig se aproxima más al rol de navegador o pager: historia, diff, blame, reflogs y exploración del estado. Puede apoyar operaciones de staging, pero su énfasis editorial no es el de un dashboard de reescritura. Ambos ejecutan o representan operaciones sobre Git: no introducen una semántica nueva de commits. El criterio de elección puede ser si predomina la inspección o la manipulación frecuente de cambios, no un benchmark imaginario de velocidad.
Una buena prueba de comprensión es ejecutar una acción pequeña desde una TUI y contrastar inmediatamente el resultado con git status, git diff --cached y git log --decorate. Si el cambio no puede explicarse desde esas vistas, la interfaz está ocultando una parte importante del modelo mental.
Integridad, firmas y automatización
Los hooks locales y CI son útiles para impedir errores habituales, pero deben tratarse como controles de calidad con alcances diferentes. Un hook puede no existir en el equipo de otro colaborador; una comprobación CI suele ser más consistente, siempre que se configure y ejecute en el servidor correspondiente.
Una firma criptográfica de commit, mediante GPG o SSH configurados en Git, es distinta del trailer Signed-off-by: este último registra una declaración semántica y no proporciona por sí mismo una prueba criptográfica. La referencia de git commit documenta ambas opciones. Ninguna firma demuestra que el código es correcto o seguro; solo permite evaluar atributos de autoría/integridad según la cadena de confianza establecida.
La disciplina técnica se resume en tres preguntas antes de compartir cambios: ¿qué entra en el snapshot?, ¿qué historia se conserva o reescribe?, ¿quién podrá interpretar y recuperar la operación después? La respuesta determina si conviene un merge, una serie revisada, un revert o una worktree temporal.
Conclusión: hacer visible lo que una interfaz oculta
Git escala de herramienta personal a protocolo de colaboración cuando el equipo entiende su modelo de estado. Las operaciones dejan de ser trucos: staging selecciona un snapshot, merge une historiales, rebase reescribe, reflog ayuda a investigar posiciones previas, bisect reduce hipótesis y worktrees separan contextos. La seguridad del workflow depende de conocer cuál de esos límites se está cruzando, no de utilizar más comandos o más plugins.
El siguiente paso natural es aplicar esa trazabilidad a sistemas que producen cambios por nosotros. La ingeniería con agentes de IA exige el mismo cuidado con diffs, revisiones, tests y recuperación; esas prácticas serán el eje del artículo dedicado a Jcode y otros coding agents cuando esté publicado.


